

从“无人区”到八项第一,这支团队让多模态大模型走进真实世界
 发布时间:2026-10-30
 信息来源:北京日报
字体:
大
中
小
 打印
发布时间:2026-10-30
信息来源:北京日报
9月,中科紫东太初开源面向物理世界的通用多模态大模型ZDTaichu5.0-9B,在九项国际空间具身理解基准中拿下八项同参数组别第一。这一新成果背后,是一场从2020年就已开始的“无人区”跋涉。
让基于国产化底座打造的多模态大模型加速走进真实世界,是中国科学院自动化研究所副总工程师、中科紫东太初董事长王金桥为团队设立的“核心使命”。
蹚出一条没人走过的路
2020年,美国旧金山,人工智能企业OpenAI宣布推出1750亿参数的大语言模型GPT-3。
彼时,尚在萌芽期的生成式人工智能还远未形成今天这样的产业共识。GPT-3发布之初,学界与科技圈不乏质疑声,不少人认为它不过是过度炒作的营销噱头,多位学者更撰文批判其“不懂语言,只是统计”。
然而,在大洋彼岸的北京,一群研究者却与尚处争议中的海外同行不谋而合。“我们意识到,生成式人工智能很可能是通向通用人工智能(AGI)的一条重要路径。”王金桥回忆道。当时,他的重点研究方向就是模式识别与机器学习。
正是基于这一判断,中国科学院自动化研究所推动成立紫东太初大模型研究中心,王金桥带领团队启动全栈国产化集中攻坚。
所谓全栈国产化,简单理解,就是从算力芯片、深度学习框架,到模型算法和产业应用,大模型的关键层级都建立在自主可控的技术体系上,并且能够彼此适配、协同运行。它要求的是“全链打通”:国产芯片要能支撑千亿参数级训练,国产框架要能调度底层算力,模型要能在这一底座上完成训练与推理,最终还要在真实场景中稳定落地。
在国产软硬件底座尚处于起步阶段的2020年,这一任务可谓挑战重重。
横亘在模型与芯片之间最关键的一道难关,是算子适配。王金桥解释,如果把大模型比作积木搭建的大厦,芯片就像提供底板、卡槽标准和拼装机械的工厂,算子则像一块块有形状、有卡槽、有功能的砖块。算子砖块能不能卡进芯片这块底板、机械臂能不能高效抓取拼装,决定了大模型这座大厦能不能盖起来、盖得快不快、省不省料。
为破解模型运行中的精度控制难题,团队探索建立了一套系统化的对照验证机制:通过统一数据与模型结构,开展基准测试,建立精度参照体系;再沿着计算链路逐层比对运行结果,追溯误差来源,精准定位关键算子,持续开展针对性优化。“模型误差要控制在5%以内,算子精度要在5‰。”王金桥直言,适配国产芯片的过程,远比想象中磨人。
在技术路线上,团队同样没有沿着当时的主流路径走。
彼时,全球最受关注的大模型,无论是“能说会道”的大语言模型,还是“能画会演”的视频生成模型,基本都局限于纯文本、图像或视频的单模态,或者图文结合的双模态。王金桥意识到,这种技术路线忽略了大量声音信息,“人类在认知世界时,往往同时涉及语音、图像、文字等信息。机器要实现更高水平的智能,就需要像人一样,发展贯通图、文、音等更多模态的大模型。”
从研发之初,王金桥和同事们就将原生多模态作为核心方向。所谓原生多模态,就是让模型从一开始就同时学习文字、图像、声音、视频、信号、光谱等不同信息,而不是先训练一个语言模型,再把其他能力“外挂”上去。
就这样,他们把一条没人走过的路,硬生生蹚了出来。
2021年7月,团队发布千亿参数多模态大模型“紫东太初”。这是全球首个中文千亿参数图文音三模态大模型,也是业内少数从芯片、框架到模型、应用全链条实现自主的大模型。这一时间点早于ChatGPT约16个月,而后者面世时仅支持文本模态,多模态能力要到GPT-4阶段才正式引入。
从“答得准”到“干得好”
2023年,全球掀起大模型热,国内大模型也迅速升温。2024年,中科紫东太初公司正式设立。
公司名字背后,是一个更早埋下的伏笔。“紫东”,取“紫气东来”之意,也暗合中国科学院自动化研究所中“自动”的发音;“太初”,则有混沌初开之意。
这四个字,并非简单的技术代号,更寄托着团队对技术源流与演进方向的深层思考——当人工智能从混沌阶段走向新的起点,中国也需要从底层技术出发、面向多模态智能的原创大模型。
这样的原创大模型,不仅要“答得准”,还要“干得好”。
早在2022年,围绕医疗物资数字化管理,王金桥团队便与国内某医疗器械标杆企业启动产学研协同项目合作,尝试让大模型从屏幕中的问答走向真实的产业现场,连接“理解”和“执行”。
医疗器械行业长期存在管理难题,仅骨科赛道就有近2万种手术耗材。术前器械可依据清单领用,最大堵点集中在术后清点归还:耗材是否使用、剩余物资是否回库、器械是否需要溯源监管,都必须精准核验。传统人工清点高度依赖人员经验,不仅耗时漫长,还容易出现错漏。
项目初期,双方先选取1000种骨科耗材开展试点验证,仅用一个月便完成技术落地,效果十分显著:以往三四十分钟的术前准备与术后耗材清点工作,被压缩到短短几分钟。
高效识别能力从何而来?正是源于原生多模态大模型所具备的世界认知能力。王金桥向记者举例:动物学家见识过大量鱼种,只需对新鱼种做一次标注,后续就能快速识别。“我们拿到一本骨科耗材图集,只需要对模型做微调,它就能自主完成耗材匹配识别。”他又以道路巡检为例:路面缺陷仅有20余种,但现场环境杂乱,树枝、烟头、杂物都会形成干扰。“拥有世界知识的大模型,可以自动过滤无关干扰项,精准锁定路面裂缝、坑洼等缺陷;缺少这种认知能力,树叶很容易被误判成水坑,产生大量无效告警。”
很快,双方联合打造出“骨科嫦娥”智慧管理平台。平台落地后,团队陆续采集了3万条数据样本和50万张图片资源,大模型基于这些数据持续训练。目前,平台对医疗耗材的识别准确率达到99.9%,练就了一双“火眼金睛”。
“骨科嫦娥”让大模型在产业现场落了地,但要从单点走向更多真实环境,模型本身还需继续“生长”。
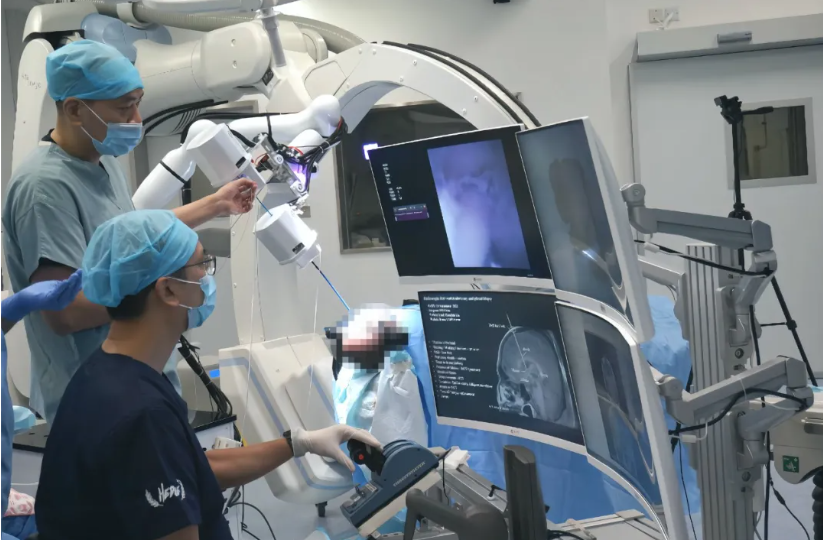
部署了紫东太初多模态大模型的颅内微创手术机器人实验现场
2023年,“紫东太初”迭代至2.0版本,雷达、红外、3D点云等更多模态的信息被纳入同一个模型,从“三模态”迈向“全模态”;2024年迭代至3.0版本时,模型不再局限于感知信息的读取,而是具备复杂任务拆解、高阶逻辑推理能力,打通感知、理解、决策与执行链路,成长为多模态智能体;2025年,“紫东太初”4.0版本面世,进一步升级为“多模态+深度推理”大模型,实现从被动信息解析到“边看、边识、边思”的主动认知跃迁,具备细粒度交互思考能力,可自主规划、推理并反馈修正,打通数字智能与物理世界交互的链路。
在汽车产线上自动“读图”识别焊接缺陷,在科研一线成为科学家的提效利器……随着能力的跃升,大模型正走向科研与产业现场,推动自主可控的通用人工智能底座加速形成。
向物理世界智能进军
9月15日,中科紫东太初开源面向物理世界的通用多模态大模型ZDTaichu5.0-9B。在横向评测中,该模型通用能力维持第一梯队水平,同时是10B参数规模内实现空间具身能力领跑的通用多模态大模型,在九项国际空间具身理解基准中拿下八项同参数组别第一。
如今,这支向大模型前沿发起冲击的北京团队,又有了新的驱动力:大模型的竞争边界,正在从数字信息处理能力,向理解和进入物理世界的能力延伸。
过去几年,大模型的能力边界快速从文本走向图像、视频、语音和代码,文档解析、图文问答、视觉数学、代码生成等数字信息处理能力已经形成成熟的产业应用体系。但当大模型真正进入机器人、智能制造和科研自动化等场景时,新的挑战出现了。
王金桥举例道,当一台机器人看到一个工作台,不仅需要知道“这里有一个杯子”,更需要进一步知道“杯子在哪里,与机械臂是什么关系,需要用多大的力、抓哪个部位拿起”。再比如,机器人抓住一只气球,根据里面装的气体不同,应对气球的方式也截然不同——氢气一松手就飞了,二氧化碳一松手就落地。可以说,这些物理、化学、材料层面的知识,对机器人真正走进物理世界至关重要。
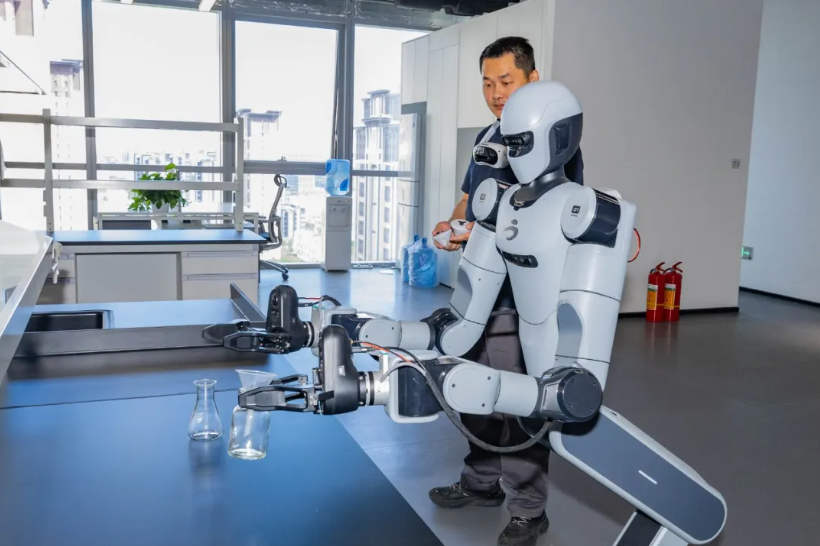
紫东太初具身智能创新实验基地内,工程师正在训练机器人做化学实验
在王金桥看来,未来不会每个大模型都是“六边形战士”,各家必然逐渐呈现差异化特色:有的擅长聊天办公,有的擅长编程规划,有的擅长图像生成。而团队要做的,是让大模型具备类人的理解能力、跨模态思考能力和交互能力,构建国产空间具身智能底座。
他认为,要具备这些能力,必须把“数理化天地生”等底层知识学得更好,成为“理科生”式的大模型,把科学知识、物理规律、材料知识、空气动力学、摩擦力等融入多模态能力。
当前,物理人工智能尚处于初级阶段。“人工智能技术迭代极快,3个月一小变,6个月一大变。一个新范式还没站稳,下一个已经涌来。”王金桥说,正因如此,团队更要沉下心把技术和产品打磨扎实。
北京的全方位支持给了他信心:公司刚成立、融资尚未完成时,北京市科委、中关村管委会就以科研专项的形式向紫东太初给予了支持,支持全栈国产化大模型研发。此后,人才政策等服务包持续完善,蓬勃的人工智能创新生态,更为企业创造了鼓励创新、开放协同的环境。
谈及未来,王金桥也为团队定下目标:把中科紫东太初打造成科学智能与具身智能领域的全球领先企业。
相关人物